
Рабочая инструкция · 2026 год
Как спарсить hh.ru в 2026 году
Расскажем как НЕ надо парсить hh.ru и как получить данные без банов и без нарушений. Так, чтобы сбор был стабильным и не вызывал санкций со стороны площадки.
Знакомая ситуация
Парсер скачали - данных не получили
Вы хотите получить вакансии и данные работодателей с hh.ru и скачиваете первый попавшийся парсер (например, Datacol, который годами закрывал именно такие задачи). Запускаете сбор - и почти мгновенно hh.ru вас банит. Данные не собираются, а иногда сайт даже перестаёт открываться в браузере. Дальше пытаетесь подобрать рабочие прокси и прочие "танцы с бубнами", но обычно их хватает ненадолго.
Ниже мы расскажем почему так происходит и как правильно получить вакансии и данные работодателей с hh.ru: без бана и прочих санкций со стороны сайта.
Проверено в 2026 году
Что говорят условия площадки
Соглашение об оказании услуг и другие правовые документы опубликованы в разделе hh.ru/article/legal. Площадка отдельно оговаривает, что база вакансий и резюме — охраняемая база данных, а доступ к резюме соискателей платный и предоставляется работодателям по договору.
В robots.txt это подтверждается технически: страницы /resume и /vacancy/* закрыты для всех ботов, включая перечисленных поимённо AI-краулеров (GPTBot, ClaudeBot, ChatGPT-User, Google-Extended, PerplexityBot и другие).
Источник: hh.ru/robots.txt.
Резюме — это персональные данные. Их массовый сбор в обход платного доступа мы не берём в работу ни в каком виде. Вакансии — публичные данные, и по ним есть законный путь: открытый API.
Редкий случай: у hh.ru есть публичный, документированный и бесплатный API для вакансий — api.hh.ru, документация для разработчиков на dev.hh.ru. Поиск вакансий доступен без авторизации, достаточно указать свой User-Agent.
curl "https://api.hh.ru/vacancies?text=python&area=1&per_page=100" \
-H "User-Agent: MyApp/1.0 (contact@example.com)"curl "https://api.hh.ru/vacancies/<id>" \
-H "User-Agent: MyApp/1.0 (contact@example.com)"API отдаёт название, компанию, зарплатную вилку, регион, опыт, тип занятости и описание. Ограничения: постраничная выдача даёт ограниченное число результатов на один поисковый запрос, поэтому широкие выборки приходится дробить на узкие фильтры. Доступ к базе резюме через открытый API не предоставляется.
Если задача — аналитика по вакансиям, рынку зарплат или мониторинг конкурентов, в 90% случаев достаточно официального API. Поможем собрать выгрузку на консультации — это законный и стабильный путь.
Вариант 2
Сторонние сервисы сбора данных
Готовые скреперы для hh.ru, которые кто-то уже написал и продаёт как услугу.
На Apify и подобных площадках есть готовые скреперы hh.ru, которые запускаются HTTP-запросом и возвращают JSON.
POST https://api.apify.com/v2/acts/<автор>~hh-scraper/run-sync-get-dataset-items?token=<APIFY_TOKEN>
Content-Type: application/json

{ "query": "аналитик", "maxItems": 100 }
Мы не тестировали такие акторы, не проверяли цены и не гарантируем их работу. Для вакансий hh.ru платить стороннему сервису обычно просто незачем — открытый API отдаёт те же данные бесплатно.
Вариант 3
Классический парсинг «в лоб»
Программа с сервера обходит страницы hh.ru и вытягивает вакансии и данные работодателей из вёрстки или внутренних запросов сайта.
Риски
Что ломается
Правовая сторона
Серая зона
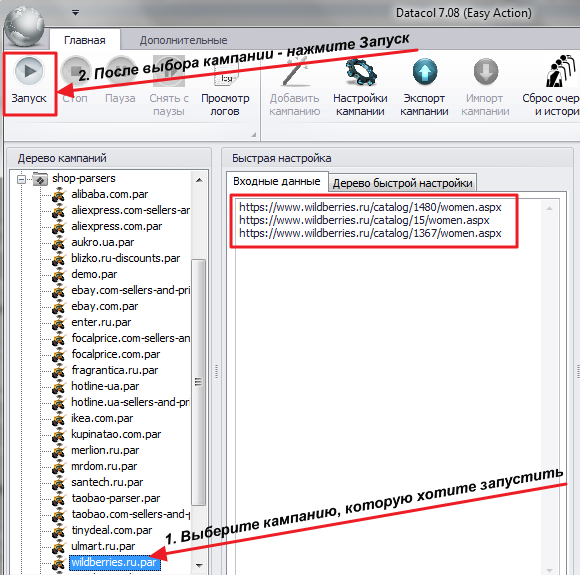
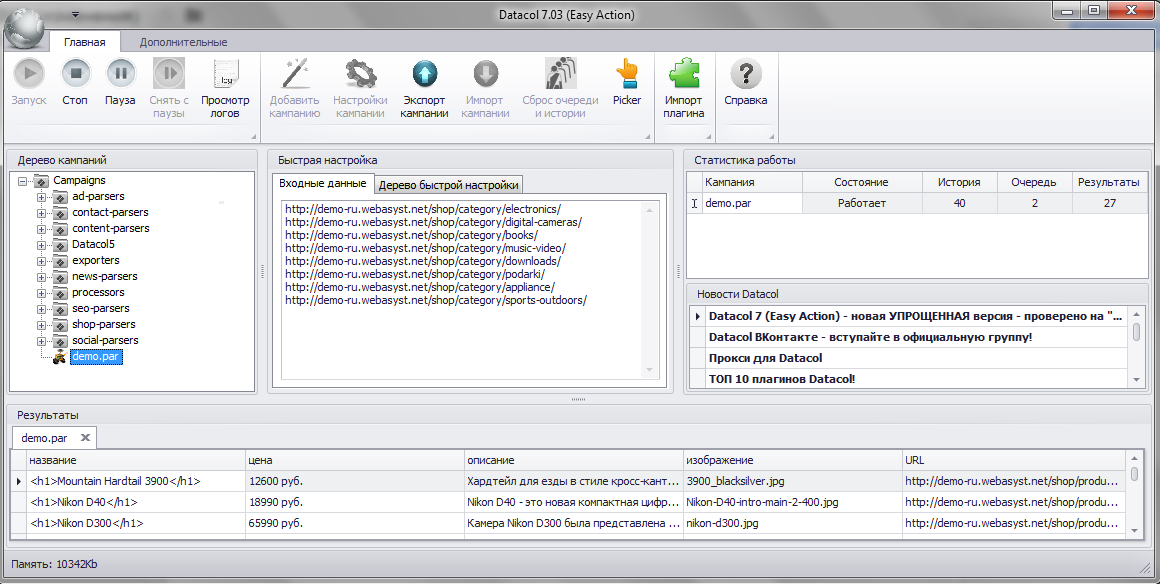
Так работает наш десктопный парсер Datacol: под hh.ru у него есть отдельная готовая кампания - вы задаёте ссылки на выдачу, программа обходит карточки и сохраняет должность, компанию, зарплату и требования в таблицу. Ниже - реальные экраны программы.
Вариант 4 · рекомендуемый
Сбор через Chrome-расширение
Данные собираются прямо в вашем браузере, на страницах hh.ru, которые вы и так открываете как обычный пользователь.
Честно
Никакой лишней нагрузки
Стабильно
Не ловит блокировки
Аккуратно
Под вашу задачу
Расширение настраивается точечно: какие поля забирать, с каких страниц и в каком формате выгружать. Как это выглядит на практике — в блоке ниже.
Рекомендуем
Демо-скрепер для hh.ru — бесплатно
Соберём рабочее Chrome-расширение под 3–5 базовых полей с hh.ru и пришлём его вам в течение 24 часов. Расширение работает в вашем браузере от вашего имени: без нагрузки на сайт и без искажения его метрик.