
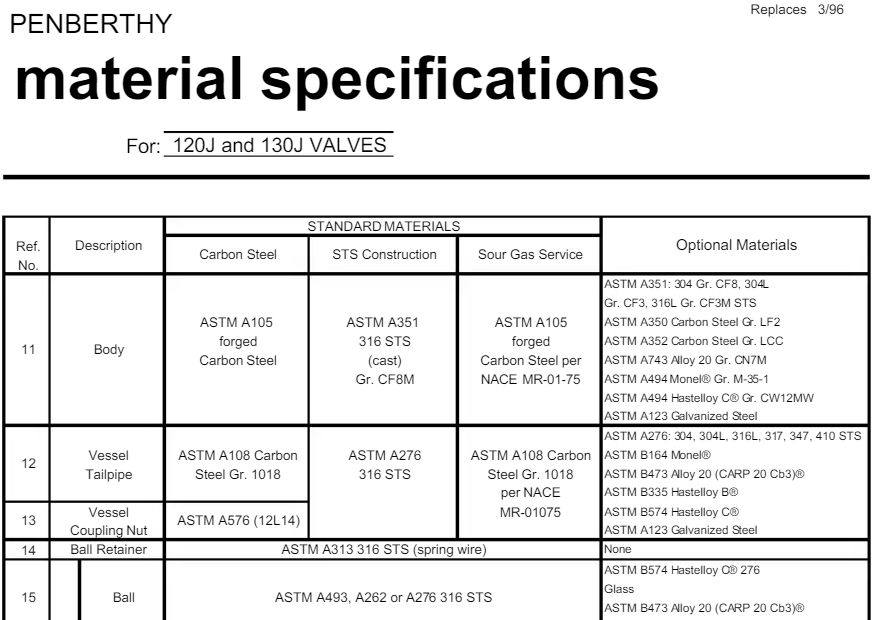
1. Плохое качество
Одна из самых больших проблем парсинга документов - низкое качество исходного материала. Документы часто приходят в виде сканов или фотографий, что создает следующие сложности:
- Размытые изображения: сканы или фотографии могут быть нечеткими, что затрудняет распознавание текста.
- Низкое разрешение: низкое качество изображения снижает точность оптического распознавания символов (OCR).
- Шумы и артефакты: пятна, линии, загибы бумаги и другие артефакты могут мешать правильному распознаванию текста.
- Рукописный текст: рукописные заметки или подписи часто оказываются трудными для автоматического распознавания.
Решение этих проблем требует алгоритмов предобработки - фильтрации шумов и улучшения контрастности, а также специализированных моделей OCR, обученных на рукописных или низкокачественных изображениях.
2. Разный layout
Вторая существенная сложность - различие в структуре документов. Инвойсы и спецификации значительно отличаются по структуре:
- Разнообразие шаблонов: каждый поставщик или клиент может использовать свой собственный шаблон документов, что делает невозможным создание универсального алгоритма.
- Изменения в форматах: компании могут периодически менять свои шаблоны, что требует постоянного обновления парсинговых алгоритмов.
- Различные языки и форматы дат: документы могут содержать информацию на разных языках, а также различные форматы дат и чисел.
Решение этой проблемы требует методов машинного обучения и NLP, обученных на разнообразных примерах шаблонов.
3. Неоднородность данных
Третья значимая сложность - неоднородность данных:
- Инконсистентность данных: один и тот же тип информации может быть представлен по-разному в разных документах.
- Ошибки и опечатки: документы могут содержать ошибки и опечатки, которые затрудняют автоматическое распознавание и обработку данных.
- Отсутствие данных: некоторые поля могут быть пустыми или содержать неполную информацию.
Решение включает нормализацию данных, алгоритмы исправления ошибок и системы валидации.
Заключение
Парсинг документов, таких как инвойсы, накладные и спецификации, сопряжен с рядом сложностей, включая плохое качество исходных материалов, разнообразие макетов и неоднородность данных. Комплексный подход, объединяющий машинное обучение, NLP, предобработку изображений и нормализацию данных, позволяет создавать эффективные системы распознавания документов.